
Je vais m’éloigner un instant des technologies immersives pour parler de l’IA après ma visite au Tech Show Paris pour prendre le pouls réel de l’offre technologique destinée aux entreprises. En laissant volontairement de côté le volet consacré aux data centers pour me concentrer sur les exposants du cloud, de l’infrastructure, de la cybersécurité et de l’intelligence artificielle, un constat s’impose à moi : le discours commercial a gagné en sobriété, mais les architectures proposées soulèvent encore de sérieuses interrogations sur la gouvernance des données, la réversibilité technique et la pérennité des éditeurs.
L’omniprésence de l’IA et le mirage de la souveraineté de façade
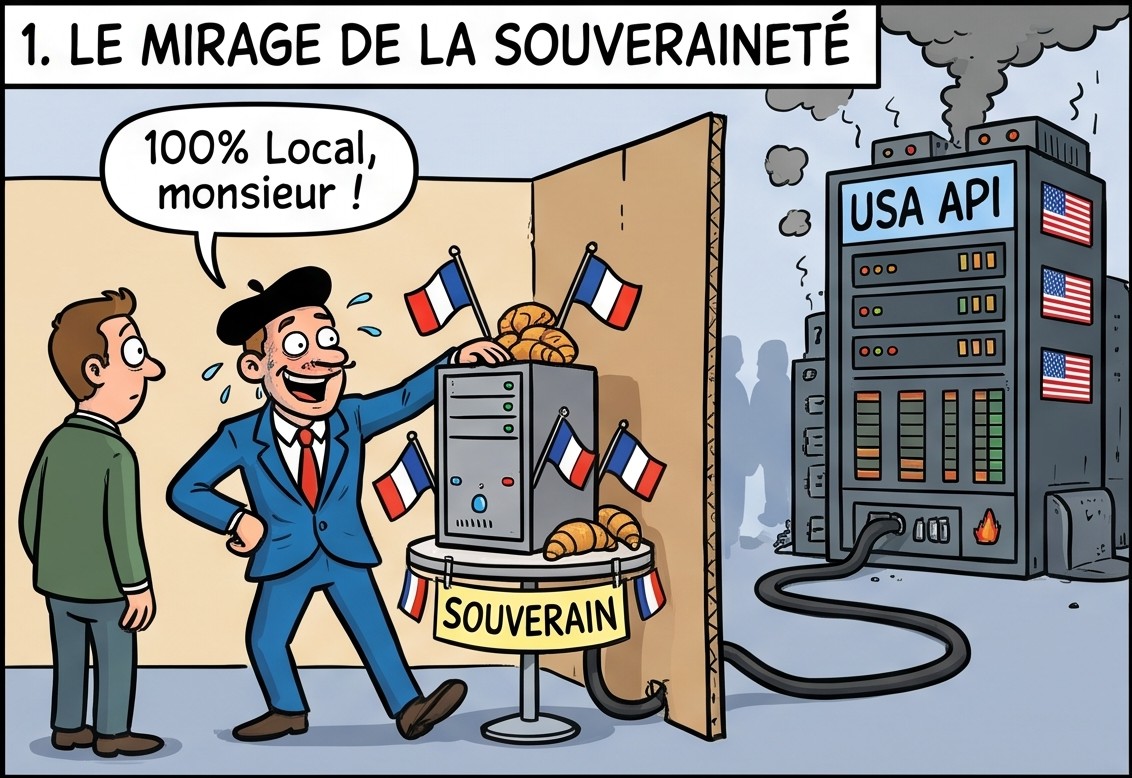
L’intelligence artificielle irrigue désormais la quasi-totalité des stands et des offres logicielles, qu’il s’agisse de renforcer les outils de cybersécurité, de piloter les infrastructures réseaux ou d’enrichir des applications métiers existantes. Contrairement aux éditions précédentes marquées par une surenchère de promesses spectaculaires, le ton se veut plus posé. Les prestataires cherchent avant tout à rassurer les décideurs en démontrant leur maîtrise technique et en plaçant les notions de souveraineté et d’hébergement local au cœur de leur argumentaire.
Bon, cet affichage de souveraineté résiste parfois difficilement à un examen technique approfondi. Lorsqu’on interroge les éditeurs sur l’architecture réelle de leurs solutions, il apparaît fréquemment que l’hébergement local ne concerne que l’interface ou une partie du stockage, tandis que le moteur d’intelligence artificielle repose sur des appels d’API vers des modèles propriétaires américains tels que Claude d’Anthropic ou les modèles d’OpenAI.
Cette dissociation entre le lieu de stockage des données et leur lieu de traitement constitue un angle mort majeur pour les entreprises clientes. Croire déployer une solution souveraine alors que les requêtes transitent par des infrastructures tierces expose les organisations à des surprises juridiques et opérationnelles. Attention, je ne dis pas que l’utilisation des API des entreprises précédemment citées « c’est le mal ». Après tout, il y a beaucoup d’informations qui ne sont absolument pas confidentielles. Mais si vous voulez vous engager dans une véritable démarche de souveraineté, cela exige d’auditer l’ensemble de la chaîne d’inférence afin de vérifier où les données sont réellement traitées, au-delà des éléments de langage marketing !
Le piège architectural de l’agent IA monolithique face au modèle modulaire
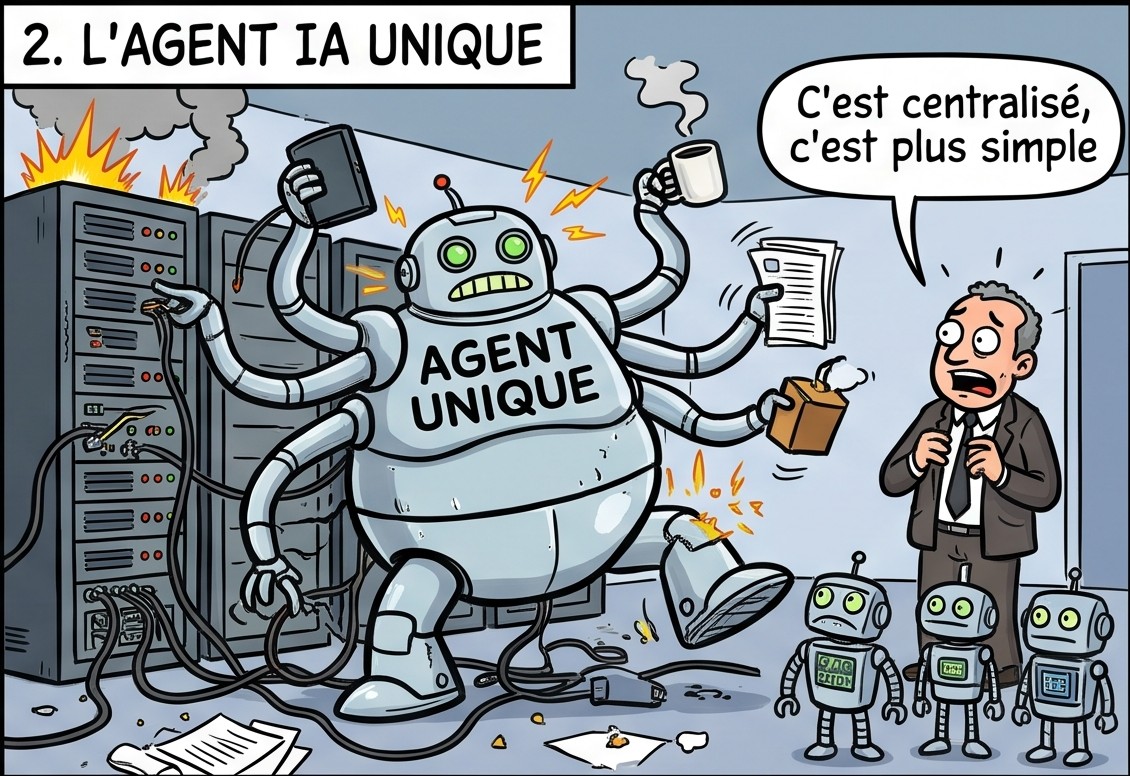
L’autre tendance lourde observée sur le salon concerne l’IA agentique, mise en avant par une majorité de prestataires. De manière surprenante (pour moi), beaucoup d’éditeurs promeuvent le concept d’un agent unique, conçu pour tout faire au sein de l’organisation. Pour accomplir ces tâches transverses, cet agent centralisé réclame un accès étendu à l’ensemble des données et des logiciels de l’entreprise.
Du point de vue de l’urbanisation d’un système d’information, cette centralisation à outrance présente des risques considérables. Si elle séduit au premier abord par sa promesse de simplicité, elle engendre une dette technique et une dépendance critique vis-à-vis du fournisseur. La sécurité globale de l’entreprise devient directement tributaire de celle de l’éditeur de l’agent, tandis que toute volonté future de changer de prestataire se heurte à la complexité d’extraire un outil profondément imbriqué dans toutes les briques logicielles existantes.
Face à ces architectures monolithiques, les approches modulaires restent étonnamment rares sur les stands. Une gouvernance saine pour moi consisterait plutôt à déployer plusieurs agents spécialisés aux périmètres strictement délimités, dotés de droits et d’habilitations précis, à l’image de collaborateurs affectés à des missions distinctes. Une telle structure facilite l’orchestration, limite l’impact d’une éventuelle défaillance et préserve la capacité de l’entreprise à remplacer un composant ou un prestataire sans paralyser l’ensemble de son système d’information.
Quand l’agent de messagerie cannibalise le CRM et fragmente la donnée
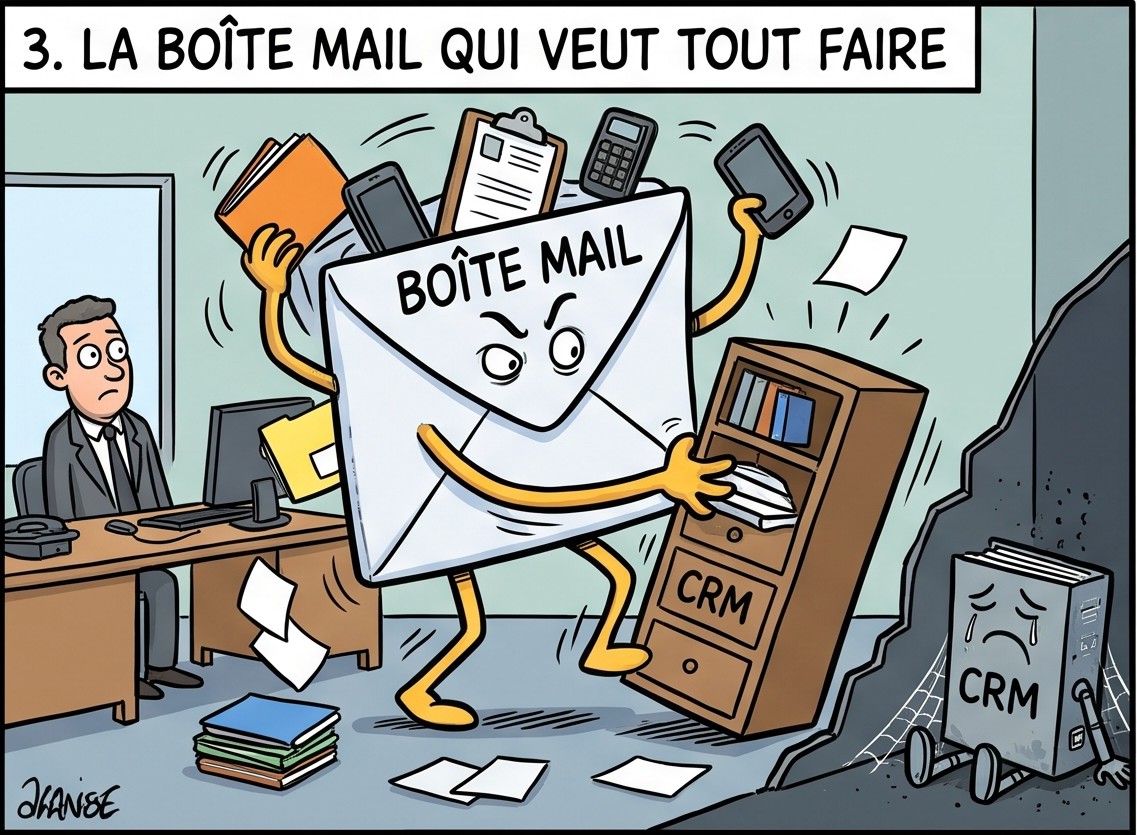
Cette volonté d’hégémonie fonctionnelle s’illustre particulièrement à travers les agents spécialisés dans la gestion des courriels professionnels. Ces outils se connectent directement aux boîtes de réception des collaborateurs pour analyser les messages entrants, hiérarchiser les priorités, préparer des listes de tâches et aller puiser des informations contextuelles dans d’autres canaux de communication avant même que l’utilisateur n’ait ouvert son client de messagerie.
En accumulant ces fonctionnalités d’analyse et de suivi, l’outil de messagerie glisse progressivement vers le terrain de la gestion de la relation client, au point d’empiéter sur le rôle traditionnel du CRM. Cette évolution pose à mon avis une question fondamentale d’architecture de données : la boîte mail a-t-elle vocation à devenir le référentiel client de l’entreprise ? Peut-être oui, peut-être non, l’important est de se poser la question ! Dans une organisation classique, ce glissement risque surtout de créer deux bases de données clients parallèles, l’une enfouie dans les flux de messagerie et l’autre structurée dans le CRM, avec tous les problèmes de synchronisation et de cohérence que cela implique.
Plutôt que d’adopter une logique d’interopérabilité, où un agent dédié à la messagerie dialoguerait avec le CRM pour l’alimenter ou même collaborerait avec un agent propre au CRM, les éditeurs cherchent à imposer leur solution comme le point d’entrée unique pour manipuler les données de l’entreprise. Cette stratégie renforce l’enfermement propriétaire (le fameux vendor lock-in) et complique la maîtrise du patrimoine informationnel par la DSI.
La vulnérabilité des surcouches RAG/LLM verticales face à l’évolution des modèles
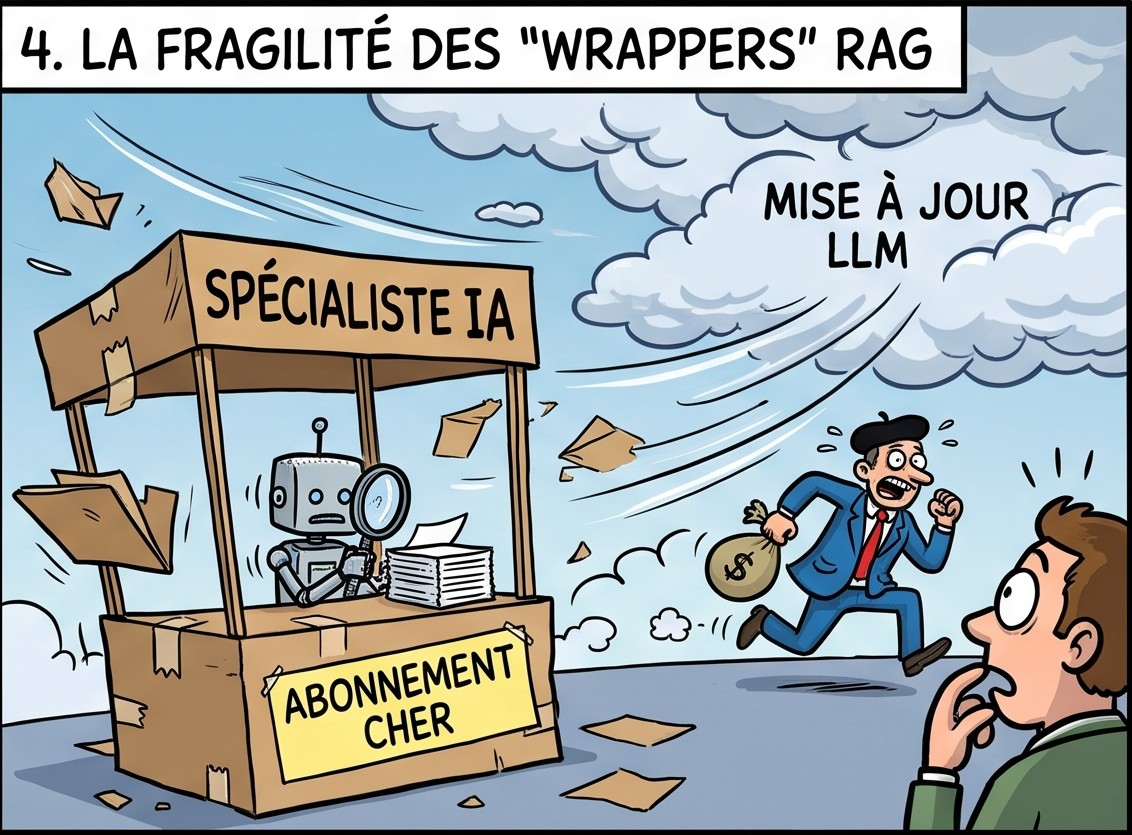
J’en suis toujours étonné, mais le salon confirme la persistance d’une catégorie d’acteurs proposant des outils verticaux hyper-spécialisés sur une niche métier ou réglementaire mais sans réellement posséder une data assez unique dans le secteur. Les exemples qui me viennent à l’esprit concernent les outils de conformité RGPD, NIS2 et autres obligations liées au numérique, mais il y a en a bien d’autres. Derrière un discours métier très ciblé, ces produits se résument techniquement à un grand modèle de langage généraliste couplé à une base documentaire via une architecture RAG (Retrieval-Augmented Generation), le tout habillé d’une interface dédiée et commercialisé sous forme d’abonnements mensuels élevés. Je conçois tout à fait que quand on s’appelle Dalloz et qu’on propose une IA spécialisée en droit, on apporte de la matière et du savoir-faire. Mais quand une startup lambda propose une IA expert-comptable, il vaut mieux se demander ou se trouve la valeur ajoutée.
Ce modèle économique de « surcouche mince » expose d’abord l’éditeur lui-même à une fragilité structurelle. Lorsque la valeur ajoutée repose essentiellement sur l’accès à un corpus réglementaire ou documentaire aisément reproductible, la barrière à l’entrée est quasi nulle. Ces acteurs risquent à tout moment d’être rattrapés et absorbés fonctionnellement dès lors que les fournisseurs de modèles de fondation comme OpenAI, Anthropic, Google ou Mistral intègrent nativement l’analyse de documents volumineux, des connecteurs métiers ou des espaces de travail spécialisés.
Pour les entreprises clientes, souscrire à ces solutions comporte un risque opérationnel et financier tout aussi direct. Elles paient au prix fort une brique technologique en voie de banalisation rapide, tout en s’exposant à voir leur fournisseur disparaître, stagner ou être racheté à bas coût dès la prochaine évolution majeure des modèles sous-jacents.
Vous l’avez compris, au-delà des démonstrations technologiques, cette édition du Tech Show Paris doit nous rappeler qu’un projet d’intelligence artificielle en entreprise reste avant tout un sujet d’architecture des systèmes d’information. Pour les décideurs, l’enjeu est d’exiger de la transparence sur le traitement réel des données, de privilégier la modularité des agents et d’évaluer la solidité économique des éditeurs avant de leur confier les clés de leurs processus métiers. Bon, après, s’ils préfèrent céder à l’attrait des interfaces les plus séduisantes et surtout de pas réfléchir et foncer… il faut bien un peu de sélection.


